Günümüz veri mimarilerinde ilişkisel veritabanlarının (RDBMS) tutarlılığı ile arama motorlarının/NoSQL platformlarının hızını bir araya getirmek kritik bir gereksinimdir. Transacting verileri barındıran kaynak veritabanındaki değişiklikleri anlık olarak yakalayıp (CDC) Elasticsearch cluster’ına aktarmak, arama performansını ve analitik süreçleri zirveye taşır.
Bu blog serimizde, Oracle GoldenGate (OGG) 23ai Microservices Architecture kullanarak, kaynak veritabanından Elasticsearch 8.x ve geleceğe hazır 9.x cluster yapısına uzanan Centralized Hub CDC mimarisini adım adım inşa edeceğiz.
1. Mimari Tasarım ve Ön Gereksinimler
Serimizin ilk bölümünde projemizin kavramsal mimarisini tasarlamış ve gereksinimleri netleştirmiştik. Bu bölümde ise teoriyi pratiğe döküyoruz. Kurulum adımlarını ve konfigürasyonları tamamen gerçek bir topoloji üzerinden, şu sunucu ve IP bilgileriyle simüle ederek ilerleteceğiz:
Hedef Elasticsearch Sunucusu: elastic.oraclius — 10.10.10.13
Kaynak Veritabanı Sunucusu: oracle.oraclius — 10.10.10.11
Merkezi Hub Sunucusu (OGG): hub.oraclius — 10.10.10.12
1.1. Neden Centralized Hub Mimarisi?
Kaynak veritabanı üzerinde operasyonel yük oluşturmamak ve replikasyon süreçlerini tek bir noktadan yönetebilmek için en modern yaklaşım Centralized Hub Architecture (Merkezi Hub Mimarisi) kullanmaktır. Bu mimarinin sağladığı temel avantajlar şunlardır:
- Sıfır Kaynak Tüketimi (Zero Overhead): Kaynak veritabanı sunucusuna herhangi bir OGG yazılımı kurulmaz. CPU, RAM ve I/O tüketimi kaynak sunucuda değil, izole edilmiş Hub sunucusunda gerçekleşir.
- Merkezi Yönetim (Single Point of Management): OGG 23ai Microservices’ın modern web arayüzü sayesinde tüm Extract ve Replicat süreçleri tek bir panelden izlenir.
- Kolay Bakım ve Yama Yönetimi (Patching): İşletim sistemi güncellemeleri veya OGG yama (Bundle Patch) yönetimleri tek bir sunucu üzerinde yapılarak kesinti süreleri minimize edilir.
- Veri Trafiği Optimizasyonu: Hub sunucusunda hem OGG for Oracle hem de OGG for Big Data yan yana (co-located) çalışacağı için, Extract sürecinin ürettiği Trail File dosyaları ağ üzerinden taşınmaz; Replicat süreci bu dosyaları yerel diskten doğrudan okur.
1.2. Mimari Tasarım ve Versiyon Uyumluluğu
Kuracağımız yapının hem mevcut sistemleri desteklemesi hem de geleceğe yönelik (ES 9.x) bir köprü oluşturması için aşağıdaki katmanlı mimariyi esas alıyoruz:
- Kaynak Veritabanı Katmanı: Transactional yükü taşıyan ve CDC (Change Data Capture) yapılacak olan ana veritabanı.
- Replikasyon (Hub) Katmanı: Üzerinde Oracle GoldenGate for Oracle ve Oracle GoldenGate for Big Data servislerini barındıran merkezi sunucu.
- Hedef Katmanı: Verilerin anlık indeksleneceği, yüksek erişilebilir (Multi-Node) Elasticsearch Cluster yapısı.
⚠️ Elasticsearch 8.x ve 9.x Geçişindeki Kritik Değişim
Elasticsearch 8.x ile birlikte gelen “Security by Default” (varsayılan SSL ve temel kimlik doğrulama) mimarisi, OGG Big Data konfigürasyonlarında köklü değişiklikler getirdi.
Elasticsearch 9.x sürümünde ise eski tip Java REST Client bağımlılıkları tamamen kaldırılarak yerine yeni Elasticsearch Java API Client entegre edildi. Bu yazı serisinde inşa edeceğimiz Replicat handler yapısı, her iki sürümün de (8 ve 9) güvenlik protokollerini ve Bulk API veri formatlarını destekleyecek parametrelerle esnek şekilde optimize edilecektir.
1.3. Altyapı ve Ön Gereksinimlerin Hazırlanması
Kuruluma geçmeden önce Hub sunucusunun ve kaynak veritabanının aşağıdaki gereksinimleri karşıladığından emin olmalıyız:
A. Centralized Hub Sunucusu Donanım ve İşletim Sistemi Özellikleri
- OS: Oracle Linux veya RHEL güncel sürümleri (64-bit).
- CPU/RAM: Eşzamanlı CDC yükünü ve Java tabanlı Big Data handler süreçlerini rahat karşılayabilmesi için izole, ölçeklenebilir donanım kaynağı.
- Storage: Trail file dosyalarının birikme ihtimaline karşı (örneğin hedef cluster’da oluşabilecek bir kesinti anında verilerin kaybolmaması için) yüksek hızlı (SSD/NVMe) ve genişleyebilir bir mount point (Örn:
/u01veya/u02).
B. Network ve Port Erişilebilirlikleri (Firewall Kuralları)
Hub sunucusu ile kaynak ve hedef lokasyonlar arasında aşağıdaki portların açık olması şarttır:
- Hub ──► Kaynak DB: SQL*Net portu (Varsayılan
1521). OGG Extract süreçleri veritabanına bu port üzerinden bağlanır. - Hub ──► ES Cluster: REST API portu (Varsayılan
9200). OGG Big Data Replicat’ları veriyi bu port üzerinden bulk olarak push eder. - İstemci (DBA) ──► Hub: OGG Microservices Service Manager ve Admin Server HTTP/HTTPS portları.
C. Oracle Client Bağımlılığı
Hub sunucusunun uzaktaki veritabanına bağlanabilmesi ve log madenciliği yapabilmesi için Hub sunucusu üzerine Oracle Database Client (Administrator yükleme tipi) kurulmalı ve TNSNAMES.ORA konfigürasyonları kaynak veritabanını görecek şekilde tamamlanmalıdır.
2: Centralized Hub Sunucusunun Hazırlanması ve OGG 23ai Kurulumu
Serimizin ilk bölümünde projemizin kavramsal mimarisini tasarlamış, IP ve Hostname topolojimizi belirlemiştik. Bu bölümde ise teoriyi pratiğe döküyoruz. Hatırlayacağınız üzere topolojimiz şu şekildeydi:
- Kaynak Veritabanı Sunucusu:
oracle.oraclius—10.10.10.11 - Merkezi Hub Sunucusu (OGG):
hub.oraclius—10.10.10.12 - Hedef Elasticsearch Sunucusu:
elastic.oraclius—10.10.10.13
Kuruluma başlamadan önce hub.oraclius sunucumuz için aşağıdaki 2 paketi indirmemiz gerekiyor. Paketlerin Microservices Architecture sürümü olduğundan emin olun:
- Oracle GoldenGate 23.26.1.0.0 on Linux x86-64 for Oracle
- GoldenGate for Distributed Applications and Analytics v23.26.1.0.0 on Linux x86-64
1. Sıfırdan OS Kullanıcısı, Gruplar ve Dizin Yapısının Oluşturulması
Tamamen temiz bir sunucuyla başladığımız için, ilk olarak GoldenGate ve Oracle Client süreçlerini yürütecek olan oracle kullanıcısını ve gerekli işletim sistemi gruplarını oluşturmamız gerekiyor. Bu adımları root kullanıcısı ile çalıştırın:
# 1. Gerekli OS gruplarını oluşturalım
groupadd -g 54321 oinstall
groupadd -g 54322 dba

# 2. oracle kullanıcısını oluşturalım ve gruplara dahil edelim
useradd -u 54321 -g oinstall -G dba oracle

# 3. oracle kullanıcısı için şifre belirleyelim
passwd oracle
Dizin Ağacının İnşası ve Yetkilendirme
Microservices mimarisinde GoldenGate ikili dosyaları (Binaries) ile dinamik olarak değişen servis verilerini (Deployment Directory) birbirinden tamamen ayırıyoruz. /u01 ve /u02 mount point’lerinizde şu dizinleri oluşturun ve sahipliğini oracle kullanıcısına verin:
# Kurulum (Yazılım) Dizinleri
mkdir -p /u01/app/oracle/product/ogg23ai_core     # OGG for Oracle Home
mkdir -p /u01/app/oracle/product/ogg23ai_bd       # OGG for Big Data Home
mkdir -p /u01/app/oracle/product/client           # Oracle Client Home

# Canlı Çalışma (Deployment) Dizinleri
mkdir -p /u02/gg_deployments/ServiceManager       # Merkezi Servis Yöneticisi
mkdir -p /u02/gg_deployments/CoreDeploy           # Extract Süreçleri Deposu
mkdir -p /u02/gg_deployments/BigDataDeploy        # Replicat Süreçleri Deposu

# Tüm dizinlerin sahipliğini oracle kullanıcısına devredelim
chown -R oracle:oinstall /u01 /u02
chmod -R 775 /u01 /u02
2. Linux İşletim Sistemi Optimizasyonları (Hub Node)
Merkezi Hub mimarisinde, yüksek girdi/çıktı (I/O) ve bellek (Memory) işlemlerinin darboğaz oluşturmaması için root yetkisiyle bazı kritik OS parametrelerini düzenlemeliyiz.
A. Çekirdek Parametreleri (/etc/sysctl.conf)
Ağ tampon belleklerinin (network buffer) yetersiz kalmaması için aşağıdaki değerleri /etc/sysctl.conf dosyasının sonuna ekleyin:
# OGG Hub Network ve Bellek Optimizasyonları
fs.file-max = 6815744
net.core.rmem_max = 4194304
net.core.wmem_max = 1048576
net.core.rmem_default = 262144
net.core.wmem_default = 262144
Değişikliklerin sunucuyu yeniden başlatmadan devreye girmesi için şu komutu çalıştırın:
sysctl -pB. Kullanıcı Limitleri (/etc/security/limits.conf)
Yeni oluşturduğumuz oracle kullanıcısının açık dosya sayısı ve kilitlenebilir bellek limitlerini artırmak için /etc/security/limits.conf dosyasına şu satırları ekleyin:
# OGG Oracle kullanıcısı kaynak limitleri
oracle   soft   nofile    65536
oracle   hard   nofile    65536
oracle   soft   nproc     16384
oracle   hard   nproc     16384
oracle   soft   memlock   500000000
oracle   hard   memlock   500000000
3. Ortam Değişkenlerinin Tanımlanması
Bu adımdan itibaren root kullanıcısından çıkıp, az önce oluşturduğumuz oracle kullanıcısına geçiş yapıyoruz (su - oracle).
oracle kullanıcısının oturum açtığında GoldenGate kütüphanelerini sorunsuz görebilmesi için ~/.bash_profile dosyasının sonuna aşağıdaki çevre değişkenlerini ekleyin:
export ORACLE_BASE=/u01/app/oracle
export ORACLE_HOME=$ORACLE_BASE/product/client
export OGG_CORE_HOME=$ORACLE_BASE/product/ogg23ai_core
export OGG_BD_HOME=$ORACLE_BASE/product/ogg23ai_bd
export LD_LIBRARY_PATH=$ORACLE_HOME/lib:$OGG_CORE_HOME/lib:$LD_LIBRARY_PATH
export PATH=$ORACLE_HOME/bin:$OGG_CORE_HOME/bin:$PATH
export NLS_LANG=AMERICAN_AMERICA.AL32UTF8
Dosyayı kaydedip yaptıktan sonra profili güncelleyin:
source ~/.bash_profile4. OGG 23ai Microservices Kurulum Aşamaları
İndirdiğimiz .zip paketlerini hub.oraclius sunucumuza transfer ettikten sonra, oracle kullanıcısı ile dosyaları açıp grafik ekran sihirbazlarını (Oracle Universal Installer) tetikliyoruz. Bu aşamada bilgisayarınızda X-Server (MobaXterm, Xming vb.) açık ve DISPLAY yönlendirmeniz etkin olmalıdır.
Aşama A: Oracle Database Client Kurulumu
Öncelikle Hub sunucusunun Oracle DB ile konuşabilmesi için client kurmalıyız. Kurulum klasörüne gidip ./runInstaller komutunu çalıştırın.
unzip LINUX.X64_2326100_client.zip -d /u01/client/
cd /u01/client/
./runInstaller
Grafik Ekran Adımları:
- Select Installation Type (Kurulum Tipi): Karşınıza gelen seçeneklerden “Administrator” olanı seçin. Uzaktan CDC operasyonları ve gelişmiş network kütüphaneleri için bu tip zorunludur. Next ile ilerleyin.
- Specify Installation Directories:
- Oracle Base:
/u01/app/oracle - Software Location (Oracle Home):
/u01/app/oracle/product/client
- Oracle Base:
- Prerequisites (Ön Gereksinimler): Kontroller bittiğinde, özet ekranında Install butonuna basarak kurulumu tamamlayın. Kurulum bitiminde root kullanıcısıyla çalıştırmanız istenen bir script çıkarsa, yeni bir terminalde root olarak çalıştırıp onaylayın.
Aşama B: Oracle GoldenGate 23ai for Oracle Kurulumu
Sıra ana motorumuz olan Core pakete geldi. İndirdiğimiz V1054774-01.zip isimli paketi açıyoruz:
# Paketi geçici bir dizine açalım
unzip V1054774-01.zip -d /u01/ogg_core_extract/
cd /u01/ogg_core_extract/fbo_ggs_Linux_x64_Oracle_services_shiphome/Disk1/

# GUI Kurulum sihirbazını tetikleyelim
./runInstaller- Installation Option:
- Oracle GoldenGate for Oracle Database 26ai and lower supported verions(1.21 GB)
- Installation Details:
- Software Location: /u01/app/oracle/product/ogg23ai_core
Aşama C: GoldenGate for Distributed Applications and Analytics Kurulumu
Şimdi sıra geldi Elasticsearch 8.x/9.x cluster’ımıza verileri JSON formatında bulk olarak push edecek Java tabanlı motoru (eski adıyla OGG for Big Data) kurmaya. İndirdiğiniz V1054817-01.zip (veya listenizdeki ilgili sürüm kodu) paketini açın:
# Big Data / Analytics paketini açalım
unzip V1054834-01.zip -d /u01/ogg_bd_replicat/
cd /u01/ogg_bd_replicat/ggs_Linux_x64_BigData_services_shiphome/Disk1/

# GUI Kurulum sihirbazını tetikleyelim
./runInstaller
Grafik Ekran Adımları:
- Software Location: Bu motorun dosyalarını izole etmek için rehberimizin başında oluşturduğumuz
/u01/app/oracle/product/ogg23ai_bddizinini yazılım evi (Home) olarak gösterin. - Installation Specifications: Big Data entegrasyonu için gerekli olan Java bağımlılık kütüphanelerinin yükleneceği bu ekranda varsayılan ayarları onaylayarak ilerleyin.
- Finish: Sihirbazı onaylayıp kurulumu başarılı şekilde sonlandırın.
5. OGG Service Manager Kurulumu (Mimarinin Kalbi)
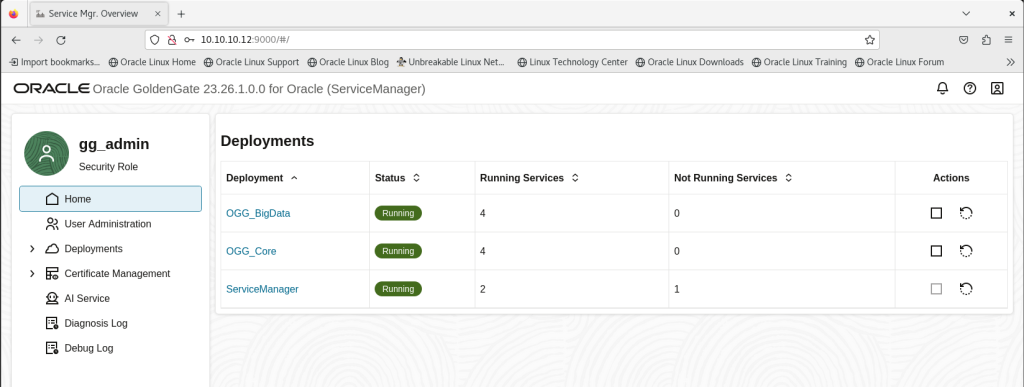
Yazılımların işletim sistemine kurulması ham dosyaların gelmesini sağladı. Şimdi hub.oraclius (10.10.10.12) üzerinde bu iki motoru ortak bir web arayüzünde birleştirecek olan Service Manager servisini ayağa kaldıracağız.
oracle kullanıcısındayken ana motorumuzun altındaki konfigürasyon sihirbazını GUI modu ile çalıştırıyoruz:
$OGG_CORE_HOME/bin/ooggca.shAçılan Grafiksel Sihirbazda Yapılacak Ayarlar:
- Service Manager Deployment
- Software Home: /u01/app/oracle/product/ogg23ai_core
- Deployment Home: /u02/gg_deployments/ServiceManager
- Hostname/IP Address: 10.10.10.11
- Port: 9000
- Register as a service/system daemon ✔
- Integrate with XAG ✖
- Remote Metrics (StatsD) ✖
- Enable Security ✖
- TLS 1.2 ✖
- TLS 1.3 ✖
- Enable FIPS ✖
- Enable plugin Service ✖
- Service Manager Administrator
- Username: gg_admin
- Password: 123456789
- Enable Strong Password Policy ✖
- User Deployment
- Deployment Name: OGG_Core
- Deployment Home: /u02/gg_deployments/CoreDeploy
- Administration Service: 9001
- Distribution Service: 9002
- Receiver Service: 9003
- Performance Metric Service: 9004
- Data Store Type: BDB
- TNS_ADMIN: /u01/app/oracle/product/client/network/admin
- Replication Schema: GGADMIN
- User Deployment Administrator
- Same as Service Manager Administrator credentials ✔
3. : OGG Big Data User Deployment Kurulumu
Bu adımda, az önce Core için yaptığımız işlemlerin benzerini Big Data paketi için yapacağız. Buradaki servisler, veriyi Java tabanlı entegrasyon kütüphaneleriyle (Handler/Formatter) işlemekten sorumlu olacak.
3.1. Grafik Ekran Sihirbazını Tetikleme
Eğer Core kurulumundan sonra sihirbazı kapattıysan, oracle kullanıcısı ile Big Data paketinin kurulu olduğu dizine giderek yapılandırma sihirbazını yeniden başlatman gerekir:
cd /u01/app/oracle/product/ogg23ai_bd/bin
./oggca.sh
Sihirbazın bu ilk ekranında, Big Data için ayırdığımız özel dizinleri ve isim tanımlamasını yapıyoruz:
- Service Manager Deployment:
- Existing Service Manager: ✔
- Hostname/IP Address: 10.10.10.12
- Port: 9000
- Enable Security: false
- Integrate with XAG: false
- Add new GoldenGate deployment: ✔
- Service Manager Administration
- Username: gg_admin
- Password: 123456789
- User Deployment
- Deployment Name: OGG_BigData
- Deployment Home: /u02/gg_deployments/BigDataDeploy
- Administration Service: 9011
- Distribution Service: 9012
- Receiver Service: 9013
- Performance Metric Service: 9014
- Data Store Type: BDB
- User Deployment Administrator
- Same as Service Manager Administrator credentials ✔
4. Kaynak Veritabanı Hazırlığı ve Extract Süreci
GoldenGate’in kaynak veritabanından veri yakalayabilmesi için Oracle 19c tarafında bazı kritik parametrelerin açık olması ve GoldenGate’e özel bir kullanıcının tanımlanması şarttır.
Adım 1: Kaynak Veritabanında (Oracle 19c) Log Mekanizmasını Açma
GoldenGate, silinen veya güncellenen verilerin eski hallerini görebilmek için veritabanının Supplemental Logging özelliğine ihtiyaç duyar.
Kaynak veritabanına SYSDBA olarak bağlanıp şu komutları sırasıyla çalıştırıyoruz:
-- Veritabanının arşiv modunda (ARCHIVELOG) olup olmadığını kontrol et, değilse arşiv moduna al.
ARCHIVE LOG LIST;

-- GoldenGate replikasyon desteğini veritabanı seviyesinde aktif et (Çok Kritik!)
ALTER SYSTEM SET ENABLE_GOLDENGATE_REPLICATION=TRUE SCOPE=BOTH;

-- Minimum supplemental logging mekanizmasını devreye al
ALTER DATABASE ADD SUPPLEMENTAL LOG DATA;

-- Değişikliklerin devreye girmesi için log switch yap
ALTER SYSTEM SWITCH LOGFILE;
Adım 2: GoldenGate Yönetici Kullanıcısının (GGADMIN) Yaratılması
GoldenGate’in logları okurken ve hedef checkpoint tablolarını yönetirken kullanacağı GGADMIN kullanıcısını kaynak veritabanında oluşturup gerekli yetkileri devrediyoruz:
-- Kullanıcıyı oluştur (Şifreyi kendine göre belirle emre babiş)
CREATE USER ggadmin IDENTIFIED BY "123456" DEFAULT TABLESPACE users TEMPORARY TABLESPACE temp;

-- Klasik DBA ve GoldenGate admin yetkilerini ver
GRANT CONNECT, RESOURCE, DBA TO ggadmin;
GRANT SELECT ANY DICTIONARY TO ggadmin;

-- GoldenGate'in log madenciliği (LogMiner) yapabilmesi için özel paket yetkileri
GRANT EXECUTE ON dbms_flashback TO ggadmin;
BEGIN
  DBMS_GOLDENGATE_AUTH.GRANT_ADMIN_PRIVILEGE('ggadmin');
END;
/
Adım 3: TNS Sırrını Çözme (tnsnames.ora)
Kurulum esnasında sihirbaza TNS_ADMIN yolu olarak /u01/app/oracle/product/client/network/admin klasörünü göstermiştik.
Şimdi bu klasörün altına gidip, oracle kullanıcısıyla tnsnames.ora dosyasını oluşturmalı ve uzaktaki Oracle 19c veritabanının bağlantı bilgilerini buraya işlemeliyiz (10.10.10.12):
vi /u01/app/oracle/product/client/network/admin/tnsnames.oraİçine şu şablonu kendi kaynak DB bilgilerine göre doldurarak yapıştır:
ORACLIUS =
  (DESCRIPTION =
    (ADDRESS = (PROTOCOL = TCP)(HOST = 10.10.10.11)(PORT = 1521))
    (CONNECT_DATA =
      (SERVER = DEDICATED)
      (SERVICE_NAME = oraclius)
    )
  )
Kaydedip çıktıktan sonra tnsping ORACLIUS yaparak bağlantının gittiğini doğrula.
/u01/app/oracle/product/client/bin/tnsping ORACLIUSAdım 4: Web Arayüzünden İlk Extract (Veri Yakalama) Sürecini Yazma
Şimdi kendi bilgisayarından tarayıcıyı açıp [https://10.10.10.12:9001](https://10.10.10.12:9001) (OGG_Core Admin Service) portuna git ve oggadmin bilgilerinle giriş yap.
- Credentials Ekleme: Sol menüden Configuration sekmesine gel.
+butonuna basarak veritabanı kimlik bilgilerini ekle:- Domain:
OracleGoldenGate - Alias:
DATABASE1 - User ID:
ggadmin@ORACLIUS - Password: Az önce SQL’de belirlediğin
ggadminşifresi (123456).
- Domain:
- TRANDATA Ekleme (Schema/Table Lock): Eklediğin bu kimliğin sağ tarafındaki “Action” menüsünden veritabanına bağlan. Sürekli takipleşmesini istediğin şemayı (Örn:
HRveyaSCOTT) seçip “Add Supplemental Log” diyerek işaretle. - Extract Oluşturma: Ana ekrana dönüp Overview kısmından Extracts başlığının yanındaki
+butonuna bas:- Extract Type:
Integrated Extractseç. - Process Name:
EX_SRC(Genel standart isimdir). - Intent:
All Operations - Credential Domain / Alias: Az önce yarattığın
OracleDBveSourceDB_Aliasseç.
- Extract Type:
- Parametre Dosyası (Parameter File): Karşına gelen konfigürasyon metin kutusuna replike etmek istediğin şemayı şu şekilde hedef göster:
--- Auto generated Parameter File, do not edit ---
EXTRACT E_EMP1
USERIDALIAS DATABASE1 DOMAIN OracleGoldenGate
EXTTRAIL A1
--- End of auto generated Parameter File ---
----------------------------------------------------
-- scn =
----------------------------------------------------
-- PERFORMANS
CACHEMGR CACHESIZE 2G
REPORTCOUNT EVERY 10000 RECORDS
WARNLONGTRANS 1h, CHECKINTERVAL 10m
----------------------------------------------------
TABLE GGADMIN.EMPLOYEES;
5. : Dağıtım Servisi (Distribution Service) ile Köprü Kurma
Bu bölümde amacımız, Core tarafındaki trail dosyalarını Big Data tarafının okuyabileceği yere otomatik pompalamak.
5.1: Hedef Big Data Tarafında Güvenlik Kartı (Credential) Tanımlama
Distribution Path (Core tarafındaki kurye), veriyi alıp Big Data’nın kapısına dayandığında içeri girebilmek için Big Data’nın tanıdığı bir kimlik göstermek zorundadır.
- Giriş:
[https://10.10.10.12:9011](https://10.10.10.12:9011)(OGG_BigData) paneline giriş yaptıktan sonra,image_9a5841.pnggörselinde en başta açık olarak duranDB Connectionssekmesine tıkla. - Ekleme: Sağ tarafta açılan ekrandan yine
+(Add Connection) veya credential ekleme butonunu kullanacağız. - Form Bilgileri:
- Target Authentication Method:
UserID Aliaskalacak. - Domain:
OracleGG - Alias:
BD_Auth_Alias - User_Id:
oggadmin(veya paneline girdiğin yetkili admin kullanıcısı) - Password: Bu kullanıcının şifresi.
Adım 1: Core Panelinden Dağıtım Yolunu (Path) Tanımlama
Kendi bilgisayarının tarayıcısından https://10.10.10.12:9002 (OGG_Core Distribution Service) portuna git veya 9001 panelindeyken sol üstteki menüden Distribution Service’e geçiş yap.
Ana ekranda Paths başlığının sağındaki + (Add Path) butonuna bas.
Açılan formda köprünün kimlik bilgilerini aynen şu şekilde doldur:
1. Path Information
- Path Name:
P_CORE_TO_BD - Description: Core’dan Big Data’ya Trail pompalama yolu.
- Air Gap Security Enabled: Seçili Değil (Unchecked).
2. Source Options
- Source Extract: E_EMP1 (Az önce kurduğun ve insert’ü yakalayan o canavar Extract’ı seçiyorsun).
- Trail Name: A1 (Extract’ın ürettiği trail dosyasının iki harfli adı).
- Subdirectory, Source, Encryption Profile, Begin, Source Log, RBA Offset: Bunların hiçbirine dokunma, boş veya varsayılan neyse öyle bırak. GoldenGate otomatik olarak en son kalınan yerden okumaya başlayacak.
3. Target Options (En Can Alıcı Adım)
- Target Protocol:
ogg - Reverse proxy enabled: Seçili Değil (Unchecked).
- Target Type (Manager, collector, Receiver Service): Buradan
Receiver Serviceseçeneğini işaretle. (Çünkü veriyi karşı tarafta9013portunda bekleyen Big Data’nın Receiver Service’ine üfleyeceğiz). - Target Host:
10.10.10.12 - Port Number:
9013(Big Data Receiver Service portun). - Trail Name:
bt(Big Data tarafında oluşacak dosyaların ön eki). - Target Type (En alttaki): Burası yine verinin binary kalması için
GGFormatolacak.
4. Advanced Options
- Buradaki hiçbir ağ optimizasyon ayarına (
compression,buffer size,tcp_nodelayvb.) dokunma, olduğu gibi varsayılan bırakıp “Next” de geç. İleride performans akort etmek istersek buraya geri döneriz.
5. Filtering Options
- Herhangi bir filtreleme yapmayacağız, şemadaki her şeyi olduğu gibi karşıya paslayacağız. Burayı da boş bırakıp direkt “Next” diyerek geç emre babiş.
6. Managed Options
- Critical: Seçili (Checked) kalabilir. (Süreç çökerse Service Manager genel durumu alert versin diye).
- Auto Restart: Seçili (Checked). (Sunucuya reboot gelirse bu kurye otomatikman kendi kendine ayağa kalksın).
- Autorestart retries / delay: Varsayılan değerlerde bırakabilirsin.
Eğer işlem başarılı ise aşağıdaki dizine bt ile başlayan trail dosyalarının geldiğini göreceksiniz:
ll /u02/gg_deployments/BigDataDeploy/var/lib/data
total 92
-rw-r----- 1 oracle oinstall 93371 Jun  5 15:47 bt000000000
6: Big Data Replicat (Uygulama) Sürecinin Kurulması
Oracle GoldenGate 23ai ekosisteminde, kaynak veritabanından yakalanan trail verilerinin hedef Big Data platformlarına (Elasticsearch, Kafka vb.) aktarılması görevini Big Data Replicat süreçleri üstlenir. Bu süreçler, hedef platformun yerel kütüphanelerini kullanarak veri transferini gerçekleştirmek adına bir Java Sanal Makinesi (JVM) tabanlı mimari işletir.
Bu bölümde; Elasticsearch Java sürücü bağımlılıklarının konumlandırılmasını, Java Delivery Handler ayarlarını ve verinin hedefe mikrosaniye seviyesinde, ara belleğe alınmadan (anlık) yazılmasını sağlayacak parametrik optimizasyonları inceleyeceğiz.
6.1. Kütüphane Bağımlılıklarının (Dependencies) Hazırlanması
GoldenGate Big Data Java Framework’ün Elasticsearch kümesi ile yerel protokoller üzerinden konuşabilmesi için gerekli olan JAR kütüphaneleri, ilgili deployment altındaki bağımlılık dizininde (/u02/gg_deployments/BigDataDeploy/var/lib/dependencies/) konumlandırılmalıdır.
Kurulum şemasında kullanılan güncel ve kararlı kütüphane bileşenleri şu şekildedir:
/u02/gg_deployments/BigDataDeploy/var/lib/dependencies/
├── elasticsearch-java-8.1.3.jar            # Ana Elasticsearch Java İstemcisi
├── elasticsearch-rest-client-8.1.3.jar      # Alt Seviye REST İstemcisi
├── httpclient-4.5.13.jar                    # HTTP Bağlantı Yönetimi
├── httpcore-4.4.15.jar                      # Çekirdek HTTP Protokol Bileşenleri
├── httpasyncclient-4.1.5.jar                # Asenkron I/O İletişimi
├── httpcore-nio-4.4.15.jar                  # Non-blocking I/O Motoru
├── jackson-databind-2.13.2.2.jar            # JSON Veri Eşleme Kütüphanesi
├── jackson-core-2.13.2.jar                  # Çekirdek JSON Ayrıştırıcı
├── jackson-annotations-2.13.2.jar           # JSON Nesne İşaretleyicileri
├── jakarta.json-api-2.0.1.jar               # Standart JSON API Standartları
├── parsson-1.0.0.jar                        # JSON İşleme Uygulaması (JSON-P)
├── commons-codec-1.11.jar                   # Veri Şifreleme/Kodlama Çözümleri
└── commons-logging-1.2.jar                  # Loglama Altyapısı
6.2. Java Delivery / Elasticsearch Konfigürasyonu (elasticsearch.properties)
Java Handler katmanının, yukarıda listelenen kütüphaneleri (classpath) nasıl yükleyeceğini ve hedef küme mimarisine hangi kimlik doğrulama tipiyle bağlanacağını belirleyen konfigürasyon dosyası aşağıdaki gibi set edilmelidir:
# Elasticsearch Handler Template
# Note: Recommended to only edit the configuration marked as TODO
gg.handlerlist=elasticsearch
gg.handler.elasticsearch.type=elasticsearch

# Elasticsearch Target Cluster Server URI List
gg.handler.elasticsearch.serverAddressList=10.10.10.13:9200
gg.handler.elasticsearch.authType=none

# Elasticsearch Java Driver Library Jars and Dependent Jars Classpath
gg.classpath=/u02/gg_deployments/BigDataDeploy/var/lib/dependencies/*
3. Anlık (Real-Time Streaming) Akış Optimizasyonu ve Parametre Yapısı (R_EMP.prm)
GoldenGate Replicat motoru, varsayılan fabrikasyon ayarlarında yüksek işlem hacmi (throughput) sağlamak ve hedef sistemdeki ağ/I/O maliyetini düşürmek amacıyla kaynak taraftan gelen transaction’ları biner biner gruplayarak (GROUPTRANSOPS 1000) toplu (batch) modda basma eğilimindedir.
Ancak veri analitiği, anlık loglama, SIEM veya canlı izleme mimarilerinde gecikme toleransı sıfırdır. Kaynak taraftan (Extract sürecinden) tek bir satır veri gelse dahi, Replicat’ın bellekte başka bir kaydın gelmesini beklemeden bu veriyi anında Elasticsearch indekslerine push etmesi istenir.
Bu yapay gecikmeyi tamamen ortadan kaldırmak ve saf anlık akışı (low-latency real-time streaming) devreye almak için transaction gruplama barajını 1 değerine çekmemiz gerekir.
Bu doğrultuda optimize edilmiş nihai Replicat parametre dosyası yapısı:
--- Auto generated Parameter File, do not edit ---
-- Parameter file for Elasticsearch replicat
REPLICAT R_EMP
--- End of auto generated Parameter File ---

-- Real-Time Streaming Optimizasyonu:
-- 1 satır veri gelse dahi tampon belleğe almadan anında hedefe yazar.
GROUPTRANSOPS 1

-- Kaynak ve Hedef Şema/Tablo Haritalama (Mapping)
MAP GGADMIN.EMPLOYEES, TARGET oraclius.employees;
4. adminclient Üzerinden Sürecin Dağıtılması ve Başlatılması
Konfigürasyon altyapısı hazırlanan Big Data Replicat süreci, GoldenGate 23ai Microservices komut satırı aracı olan adminclient üzerinden hedef deployment’a tescil edilerek devreye alınır:
-- 1. İlgili Big Data Deployment Servisine Bağlanılması
CONNECT http://10.10.10.12:9011 DEPLOYMENT BigDataDeploy AS oggadmin

-- 2. Replicat Sürecinin Gerçek Trail Kaynağı (bt) Gösterilerek Oluşturulması
ADD REPLICAT R_EMP, TRAILSOURCE var/lib/data/bt

-- 3. Sürecin Aktif Hale Getirilmesi
START REPLICAT R_EMP
Bu adımların ardından süreç, kuyruk yönetimini tamamen devre dışı bırakarak kaynak veritabanında üretilen her bir değişikliği (DML) milisaniyeler seviyesinde Elasticsearch kümesine aktarmaya başlayacaktır. Aktarılan canlı operasyon verilerini ve anlık istatistikleri izlemek için STATS REPLICAT R_EMP komutu kullanılabilir.
7. Elasticsearch Handler ile Dinamik İndeks Yönetimi ve Ingest Pipeline Çözümü
Oracle GoldenGate for Distributed Applications and Analytics (Big Data) mimarisinde, verileri hedef sisteme basarken en çok ihtiyaç duyulan senaryolardan biri verinin içeriğine (örneğin bir tarih kolonuna) göre dinamik indeksler (emre_202606 gibi) oluşturmaktır.
Ancak GoldenGate Elasticsearch Handler kütüphanesinin (ElasticSearchHandler) doğası gereği, Kafka veya File Writer handler’larında bulunan indexMappingTemplate gibi dinamik token parametreleri bu sınıfta desteklenmez. Elasticsearch Handler, hedef indeks ismini doğrudan Replicat parametre dosyasındaki (.prm) TARGET tanımından (schema.table -> schema_table) otomatik olarak türetir ve sabit bir indekse yazar.
Bu kısıtlamayı aşmanın ve mimariyi production ortamında en performanslı şekilde çalıştırmanın yolu, dinamik indeksleme yükünü Elasticsearch’ün Ingest Pipeline yeteneklerine devretmektir.
1. Adım: Elasticsearch Ingest Pipeline Oluşturulması
Öncelikle Elasticsearch tarafında, GoldenGate’ten gelen verinin içindeki HIRE_DATE kolonunu analiz edecek ve dokümanı gitmesi gereken dinamik indekse yönlendirecek bir Painless betiği hazırlıyoruz.
Aşağıdaki API çağrısı ile gg_dynamic_index_pipeline isimli pipeline’ı Elasticsearch üzerinde tanımlayın:
PUT _ingest/pipeline/gg_dynamic_index_pipeline
{
  "description": "HIRE_DATE alanına göre verileri dinamik emre_YYYYMM indekslerine yönlendirir",
  "processors": [
    {
      "script": {
        "lang": "painless",
        "source": """
          if (ctx.containsKey('HIRE_DATE') && ctx.HIRE_DATE != null) {
            String hd = ctx.HIRE_DATE.toString();
            // Tarih formatının (YYYY-MM-DD) uzunluğunu kontrol et
            if (hd.length() >= 7) {
              String year = hd.substring(0, 4);
              String month = hd.substring(5, 7);
              ctx._index = 'emre_' + year + month;
            }
          }
        """
      }
    }
  ]
}
2. Adım: Elasticsearch Index Template ve Default Pipeline Tanımı
GoldenGate’in hedef olarak göreceği sabit indeks (oraclius_employees) tetiklendiğinde, yukarıda yazdığımız pipeline’ın otomatik olarak devreye girmesi için bir indeks şablonu (Index Template) oluşturuyoruz:
PUT _index_template/oraclius_employees_template
{
  "index_patterns": ["oraclius_employees"],
  "template": {
    "settings": {
      "index.default_pipeline": "gg_dynamic_index_pipeline"
    }
  }
}
3. Adım: GoldenGate Replicat Parametre Dosyası (R_EMP.prm)
Mimarinin Elasticsearch tarafını kurduktan sonra, GoldenGate tarafındaki konfigürasyonu karmaşık token ve string operasyonlarından arındırarak en sade ve kararlı haline getiriyoruz:
REPLICAT R_EMP
GROUPTRANSOPS 1
MAP GGADMIN.EMPLOYEES, TARGET oraclius.employees;
4. Adım: Java Adapter Konfigürasyonu (elasticsearch.properties)
Geçersiz parametre kullanımından kaynaklı OGG-15051 Java or JNI exception / DBUTIL-00032 (Process Abending) hatalarının önüne geçmek için, properties dosyasını sadece resmi olarak desteklenen ve optimize edilmiş parametrelerle yapılandırıyoruz:
# ====================================================================
# Oracle GoldenGate Big Data Adapter - Elasticsearch Handler Config
# ====================================================================

# Handler Tanımlaması
gg.handlerlist=elasticsearch
gg.handler.elasticsearch.type=elasticsearch

# Elasticsearch Sunucu Bağlantı Bilgileri
gg.handler.elasticsearch.serverAddressList=10.10.10.13:9200
gg.handler.elasticsearch.authType=none

# Sürücü ve Bağımlılık Kütüphanelerinin Yolu (Classpath)
gg.classpath=/u02/gg_deployments/BigDataDeploy/var/lib/dependencies/*

# Performans ve Yazma Stratejisi
gg.handler.elasticsearch.bulkWrite=true
gg.handler.elasticsearch.upsert=true
Bir yanıt yazın